CosyVoice 训练
1 流程
- 准备语音集(参考 GPT-SoVITS 训练 中的 2-7 步)
- 安装 CosyVoice
- 准备目录和数据
- 准备训练脚本
- 开始训练
- 复制模型
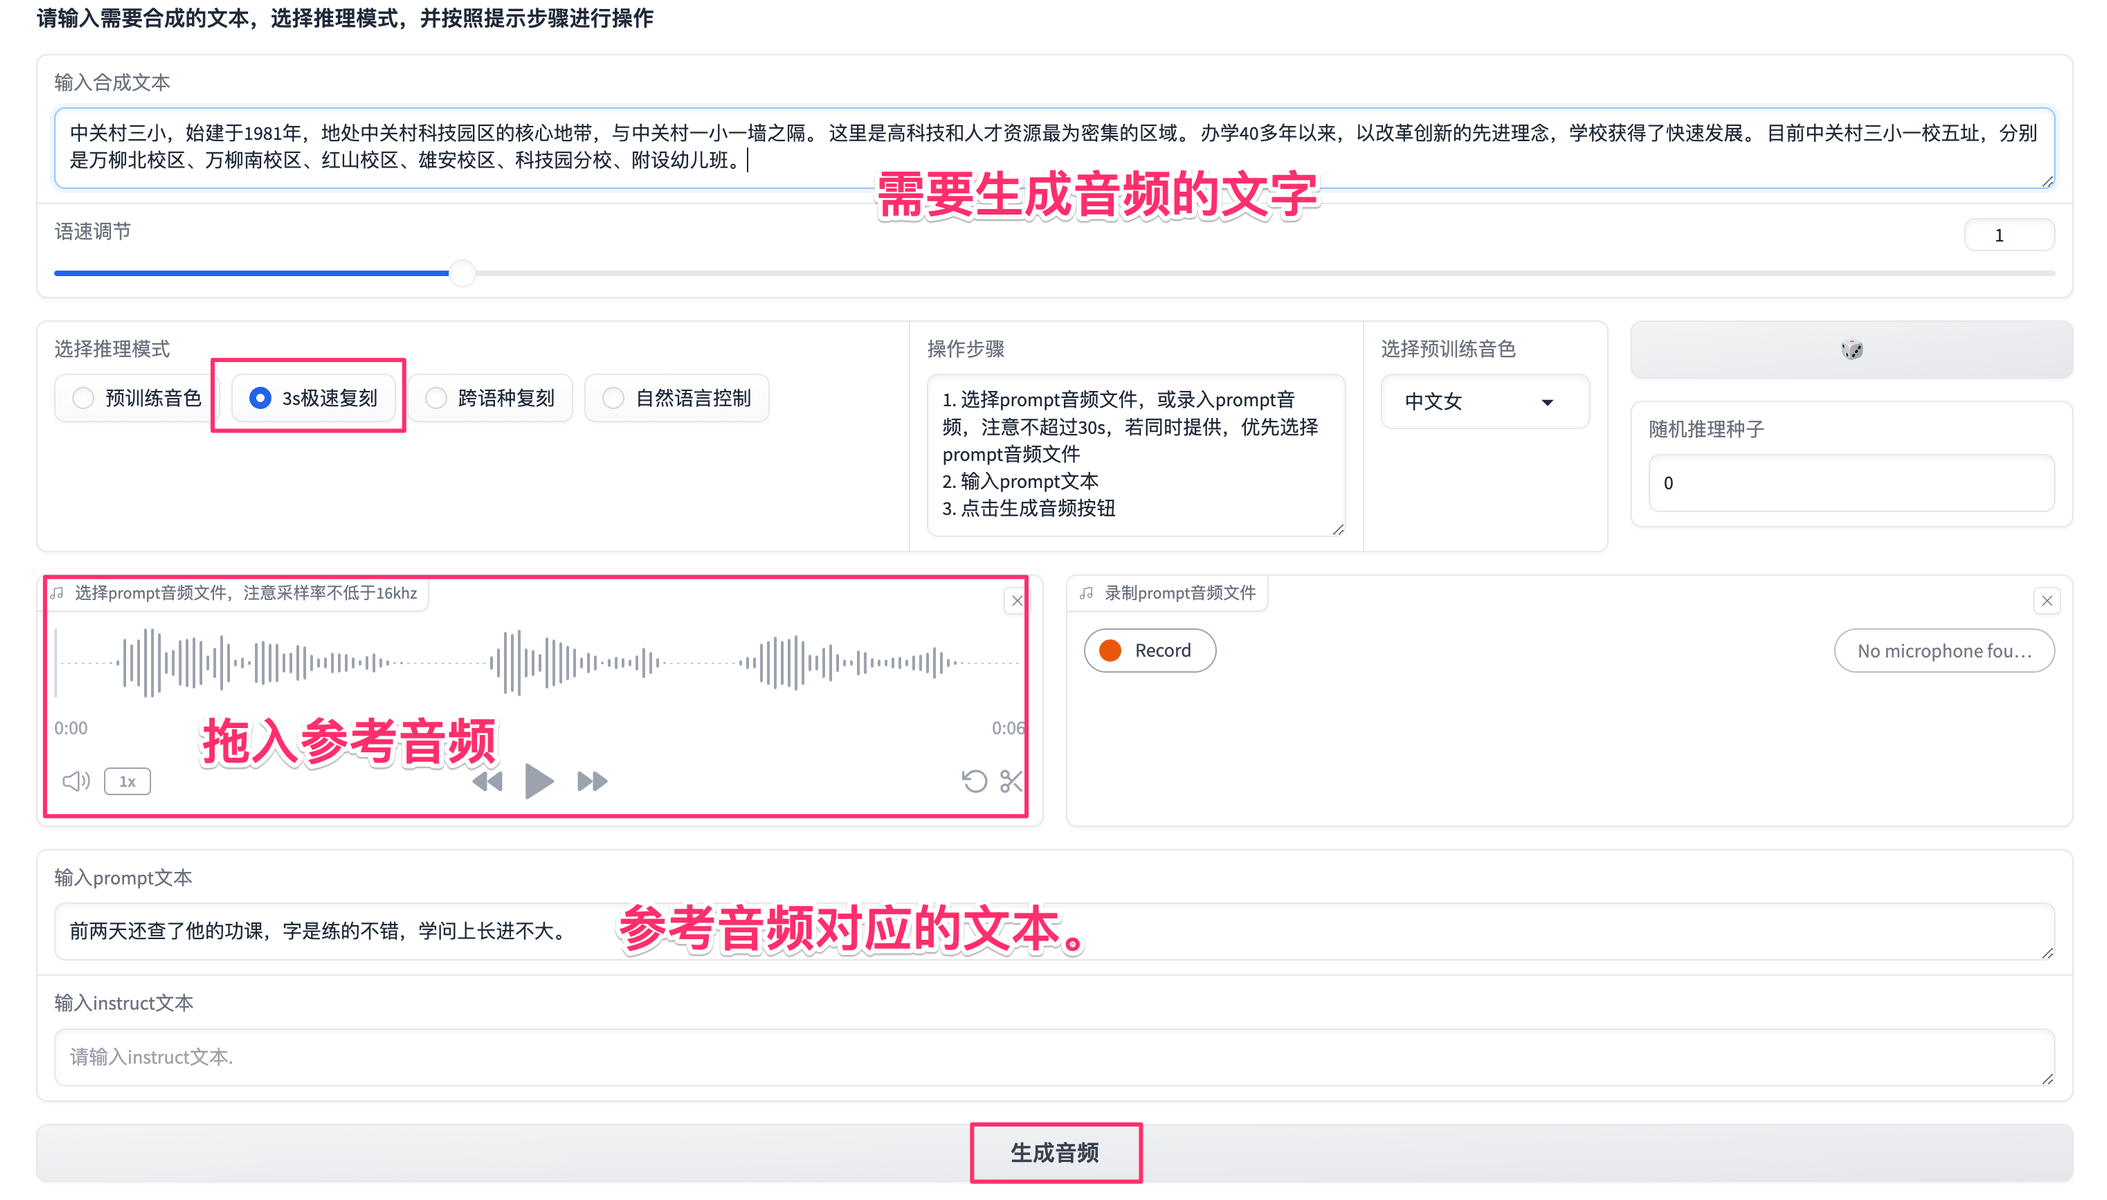
- 推理
2 安装 CosyVoice
基础目录:/home
git clone --recursive https://github.com/FunAudioLLM/CosyVoice.git
cd CosyVoice
git submodule update --init --recursive

conda create -n cosyvoice python=3.8
conda activate cosyvoice
conda install -y -c conda-forge pynini==2.1.5
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
apt-get install sox libsox-dev

mkdir -p pretrained_models
git clone https://www.modelscope.cn/iic/CosyVoice-300M.git pretrained_models/CosyVoice-300M
git clone https://www.modelscope.cn/iic/CosyVoice-300M-SFT.git pretrained_models/CosyVoice-300M-SFT
git clone https://www.modelscope.cn/iic/CosyVoice-300M-Instruct.git pretrained_models/CosyVoice-300M-Instruct
git clone https://www.modelscope.cn/iic/CosyVoice-ttsfrd.git pretrained_models/CosyVoice-ttsfrd

cd pretrained_models/CosyVoice-ttsfrd/
unzip resource.zip -d .
pip install ttsfrd-0.3.6-cp38-cp38-linux_x86_64.whl
3 准备目录和数据
cd examples/libritts/cosyvoice
mkdir data
cd data
mkdir test train
CosyVoice/examples/libritts/cosyvoice/data/
├── test
└── train
CosyVoice/examples/libritts/cosyvoice/asr.sh
#!/bin/bash

# 基础路径
BASE_DIR="/home/GPT-SoVITS"
INPUT_FILE="${BASE_DIR}/output/asr_opt/slicer_opt.list"

# 检查输入文件是否存在
if [[ ! -f $INPUT_FILE ]]; then
    echo "输入文件不存在: $INPUT_FILE"
    exit 1
fi

# 读取文件并处理每一行
while IFS='|' read -r file_path opt_type lang text; do
    # 拼接完整的文件路径
    full_file_path="${BASE_DIR}/${file_path}"
    # 提取目录和文件名
    dir_path=$(dirname "$full_file_path")
    base_name=$(basename "$full_file_path" .wav)
    # 生成目标文件路径
    output_file="${dir_path}/${base_name}.normalized.txt"
    # 将文本写入目标文件
    echo "$text" > "$output_file"
    echo "生成文件: $output_file"
done < "$INPUT_FILE"

echo "所有文件处理完成。"
修改 INPUT_FILE ,确保使用 GPT-SoVITS 训练 中的 2-7 步准备好语音集后,运行 asr.sh
会在 /home/GPT-SoVITS/output/slicer_opt 中生成很多 .normalized.txt 文件。
CosyVoice/examples/libritts/cosyvoice/copy_data.sh
#!/bin/bash

BASE_DIR="/home/GPT-SoVITS/output/slicer_opt"
TARGET_DIR="/home/CosyVoice/examples/libritts/cosyvoice/data"
TRAIN_DIR="${TARGET_DIR}/train"
TEST_DIR="${TARGET_DIR}/test"

# 创建目标目录(如果不存在)
mkdir -p "${TRAIN_DIR}"
mkdir -p "${TEST_DIR}"

# 获取所有 .wav 文件的列表
files=($(find "${BASE_DIR}" -maxdepth 1 -name "*.wav"))

# 计算需要分配到训练集的文件数量
total_files=${#files[@]}
train_count=$(echo "scale=0; ${total_files} * 0.9 / 1" | bc)

# 遍历文件并进行复制
for i in "${!files[@]}"; do
    filename=$(basename "${files[$i]}" .wav)
    wav_file="${BASE_DIR}/${filename}.wav"
    normalized_file="${BASE_DIR}/${filename}.normalized.txt"

    # 检查 .wav 和 .normalized.txt 文件是否都存在
    if [ -f "$wav_file" ] && [ -f "$normalized_file" ]; then
        # 判断当前文件是属于前 90% 还是后 10%
        if [ "$i" -lt "$train_count" ]; then
            cp "$wav_file" "$TRAIN_DIR/"
            cp "$normalized_file" "$TRAIN_DIR/"
        else
            cp "$wav_file" "$TEST_DIR/"
            cp "$normalized_file" "$TEST_DIR/"
        fi
    else
        echo "文件 ${filename} 的 .wav 或 .normalized.txt 文件缺失,跳过此文件。"
    fi
done

echo "文件复制完成。"
确认 BASE_DIR 和 TARGET_DIR 正确,然后运行 copy_data.sh,会把数据集中的 90% 放到 train 目录,10% 放到 test 目录。
4 训练脚本
4.1 修改脚本
4.1.1 train.sh
/home/CosyVoice/examples/libritts/cosyvoice/train.sh
#!/bin/bash
# Copyright 2024 Alibaba Inc. All Rights Reserved.
#

export CUTLASS_PATH=/home/cutlass

. ./path.sh || exit 1;

stage=0
stop_stage=5

pretrained_model_dir=../../../pretrained_models/CosyVoice-300M

# 语音集存放的目录,里面包含了test和train
data_dir=/home/CosyVoice/examples/libritts/cosyvoice/data

# stage 1
if [ ${stage} -le 0 ] && [ ${stop_stage} -ge 0 ]; then
  echo "Data preparation, prepare wav.scp/text/utt2spk/spk2utt"
  for x in test train; do
    mkdir -p data/$x
    python local/prepare_data.py --src_dir $data_dir/$x --des_dir data/$x
  done
fi

# stage 2
if [ ${stage} -le 1 ] && [ ${stop_stage} -ge 1 ]; then
  echo "Extract campplus speaker embedding, you will get spk2embedding.pt and utt2embedding.pt in data/$x dir"
  for x in test train; do
    tools/extract_embedding.py --dir data/$x \
      --onnx_path $pretrained_model_dir/campplus.onnx
  done
fi

# stage 3
if [ ${stage} -le 2 ] && [ ${stop_stage} -ge 2 ]; then
  echo "Extract discrete speech token, you will get utt2speech_token.pt in data/$x dir"
  for x in test train; do
    tools/extract_speech_token.py --dir data/$x \
      --onnx_path $pretrained_model_dir/speech_tokenizer_v1.onnx
  done
fi

# stage4
if [ ${stage} -le 3 ] && [ ${stop_stage} -ge 3 ]; then
  echo "Prepare required parquet format data, you should have prepared wav.scp/text/utt2spk/spk2utt/utt2embedding.pt/spk2embedding.pt/utt2speech_token.pt"
  for x in test train; do
    mkdir -p data/$x/parquet
    tools/make_parquet_list.py --num_utts_per_parquet 1000 \
      --num_processes 10 \
      --src_dir data/$x \
      --des_dir data/$x/parquet
  done
fi

# train llm
# 只用id=0的N卡训练
export CUDA_VISIBLE_DEVICES="0"
num_gpus=$(echo $CUDA_VISIBLE_DEVICES | awk -F "," '{print NF}')
job_id=1986
dist_backend="nccl"
num_workers=8
prefetch=200
train_engine=torch_ddp
if [ ${stage} -le 5 ] && [ ${stop_stage} -ge 5 ]; then
  echo "Run train. We only support llm traning for now. If your want to train from scratch, please use conf/cosyvoice.fromscratch.yaml"
  if [ $train_engine == 'deepspeed' ]; then
    echo "Notice deepspeed has its own optimizer config. Modify conf/ds_stage2.json if necessary"
  fi
  cat data/train/parquet/data.list > data/train.data.list
  cat data/test/parquet/data.list > data/dev.data.list
  for model in llm; do
    torchrun --nnodes=1 --nproc_per_node=$num_gpus \
        --rdzv_id=$job_id --rdzv_backend="c10d" --rdzv_endpoint="localhost:0" \
      cosyvoice/bin/train.py \
      --train_engine $train_engine \
      --config conf/cosyvoice.yaml \
      --train_data data/train.data.list \
      --cv_data data/dev.data.list \
      --model $model \
      --checkpoint $pretrained_model_dir/$model.pt \
      --model_dir `pwd`/exp/cosyvoice/$model/$train_engine \
      --tensorboard_dir `pwd`/tensorboard/cosyvoice/$model/$train_engine \
      --ddp.dist_backend $dist_backend \
      --num_workers ${num_workers} \
      --prefetch ${prefetch} \
      --pin_memory \
      --deepspeed_config ./conf/ds_stage2.json \
      --deepspeed.save_states model+optimizer
  done
fi
4.1.2 prepare_data.py
修改 examples/libritts/cosyvoice/local/prepare_data.py
import argparse
import logging
import glob
import os
from tqdm import tqdm


logger = logging.getLogger()

def main():
    # {}/*/*/*wav 改为了 {}/*wav
    wavs = list(glob.glob('{}/*wav'.format(args.src_dir)))

    utt2wav, utt2text, utt2spk, spk2utt = {}, {}, {}, {}
    for wav in tqdm(wavs):
        txt = wav.replace('.wav', '.normalized.txt')
        if not os.path.exists(txt):
            logger.warning('{} do not exsist'.format(txt))
            continue
        with open(txt) as f:
            content = ''.join(l.replace('\n', '') for l in f.readline())
        utt = os.path.basename(wav).replace('.wav', '')
        spk = utt.split('_')[0]
        utt2wav[utt] = wav
        utt2text[utt] = content
        utt2spk[utt] = spk
        if spk not in spk2utt:
            spk2utt[spk] = []
        spk2utt[spk].append(utt)

    with open('{}/wav.scp'.format(args.des_dir), 'w') as f:
        for k, v in utt2wav.items():
            f.write('{} {}\n'.format(k, v))
    with open('{}/text'.format(args.des_dir), 'w') as f:
        for k, v in utt2text.items():
            f.write('{} {}\n'.format(k, v))
    with open('{}/utt2spk'.format(args.des_dir), 'w') as f:
        for k, v in utt2spk.items():
            f.write('{} {}\n'.format(k, v))
    with open('{}/spk2utt'.format(args.des_dir), 'w') as f:
        for k, v in spk2utt.items():
            f.write('{} {}\n'.format(k, ' '.join(v)))
    return

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument('--src_dir',
                        type=str)
    parser.add_argument('--des_dir',
                        type=str)
    args = parser.parse_args()
    main()
4.1.3 cosyvoice.yaml
修改 /home/CosyVoice/examples/libritts/cosyvoice/conf/cosyvoice.yaml 的最后的 train_conf 部分的配置
# train conf
train_conf:
    optim: adam
    optim_conf:
        lr: 0.00001 # change to 1e-5 during sft
    scheduler: warmuplr # change to constantlr during sft
    scheduler_conf:
        warmup_steps: 2500
    max_epoch: 10  # 最大轮数
    grad_clip: 5
    accum_grad: 2
    log_interval: 100
    save_per_step: -1
4.2 开始训练
模型会保存在 /home/CosyVoice/examples/libritts/cosyvoice/exp 中,因此先要删除 exp 目录
然后运行,运行 ./trian.sh
5 复制模型
训练出来的模型在 CosyVoice/examples/libritts/cosyvoice/exp/cosyvoice/llm/torch_ddp
-rw-r--r-- 1 root 1243027089 Aug  9 13:45 epoch_0_whole.pt
-rw-r--r-- 1 root       1514 Aug  9 13:45 epoch_0_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:47 epoch_1_whole.pt
-rw-r--r-- 1 root       1513 Aug  9 13:47 epoch_1_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:49 epoch_2_whole.pt
-rw-r--r-- 1 root       1513 Aug  9 13:49 epoch_2_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:51 epoch_3_whole.pt
-rw-r--r-- 1 root       1513 Aug  9 13:51 epoch_3_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:53 epoch_4_whole.pt
-rw-r--r-- 1 root       1527 Aug  9 13:53 epoch_4_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:55 epoch_5_whole.pt
-rw-r--r-- 1 root       1515 Aug  9 13:55 epoch_5_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:57 epoch_6_whole.pt
-rw-r--r-- 1 root       1525 Aug  9 13:57 epoch_6_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 13:59 epoch_7_whole.pt
-rw-r--r-- 1 root       1525 Aug  9 13:59 epoch_7_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 14:01 epoch_8_whole.pt
-rw-r--r-- 1 root       1527 Aug  9 14:01 epoch_8_whole.yaml
-rw-r--r-- 1 root 1243027089 Aug  9 14:03 epoch_9_whole.pt
-rw-r--r-- 1 root       1525 Aug  9 14:03 epoch_9_whole.yaml
-rw-r--r-- 1 root 1242997798 Aug  9 13:43 init.pt
-rw-r--r-- 1 root        783 Aug  9 13:43 init.yaml
先备份 pretrain 模型中的 pt 文件,然后把最后的 pt 模型覆盖 pretrain 模型的 llm.pt
cp /home/CosyVoice/pretrained_models/CosyVoice-300M/llm.pt /home/CosyVoice/pretrained_models/CosyVoice-300M/llm.pt.orig
cp /home/CosyVoice/examples/libritts/cosyvoice/exp/cosyvoice/llm/torch_ddp/epoch_9_whole.pt /home/CosyVoice/pretrained_models/CosyVoice-300M/llm.pt
6 推理
运行 run.sh
#!/bin/bash

export CUDA_VISIBLE_DEVICES=0

source /root/miniconda3/bin/activate cosyvoice
cd /home/CosyVoice

python3 webui.py --port 50000 --model_dir pretrained_models/CosyVoice-300M